Содержание статьи
- Что такое контекстное окно простыми словами?
- Что входит в контекстное окно модели?
- Почему модель забывает начало диалога?
- Какой размер контекстного окна у ChatGPT, Claude, Gemini и DeepSeek?
- Чем контекстное окно отличается от памяти?
- Чем больше окно, тем лучше?
- Как работать с контекстом, чтобы нейросеть не теряла важное?
- Источники
- Частые вопросы
Коротко
- Контекстное окно — это объём текста в токенах, который нейросеть видит за один раз: ваш запрос, история чата, файлы, инструкции и сам ответ.
- Когда переписка не помещается в окно, сервис обрезает или сжимает старые сообщения. Отсюда ощущение, что ИИ «забыл» начало.
- Размер окна зависит от модели и тарифа: в ChatGPT от 27 тысяч токенов на бесплатном тарифе, у новых моделей Claude, Gemini и DeepSeek до миллиона.
- Большое окно не гарантирует внимательность: даже в пределах окна модель хуже находит то, что лежит в середине длинного текста.
Что такое контекстное окно простыми словами?
Контекстное окно — это рабочая память языковой модели на один ответ. Всё, что модель учитывает, когда пишет ответ, должно поместиться в это окно. Что в окно не попало, для модели в этот момент не существует.
Google в документации Gemini сравнивает окно с кратковременной памятью человека: она вмещает ограниченный объём информации. Anthropic формулирует так: контекстное окно — это весь текст, на который модель может опираться при генерации ответа, включая сам ответ. И отдельно подчёркивает, что это не те данные, на которых модель обучали. Обучение — это «знания», окно — то, что лежит перед моделью прямо сейчас.
В канале пишу то, что не доезжает до статьи.Короткие заметки и тесты нейросетей
Читать каналРазмер окна считают в токенах, а не в словах или знаках. Токен — кусок текста: слово, часть слова или знак. Русский текст занимает больше токенов, чем английский того же смысла, поэтому в одно и то же окно его помещается меньше. Подробно про единицу счёта — в статье что такое токены в нейросети.
Что входит в контекстное окно модели?
Новички обычно думают, что окно — это их вопрос. На деле в нём лежит гораздо больше. По документации Anthropic, в окно идёт всё, что есть в запросе:
- Системный промпт и инструкции. Скрытые правила сервиса, ваши личные настройки и описания инструментов.
- Вся история диалога. Каждое ваше сообщение и каждый ответ модели с начала разговора.
- Файлы и картинки. Загруженный документ занимает место так же, как текст, который вы вставили руками.
- Результаты инструментов. Найденные в интернете страницы, вывод кода, данные из подключённых сервисов.
- Ответ модели. И видимый текст, и скрытые рассуждения, если модель «думает» перед ответом.
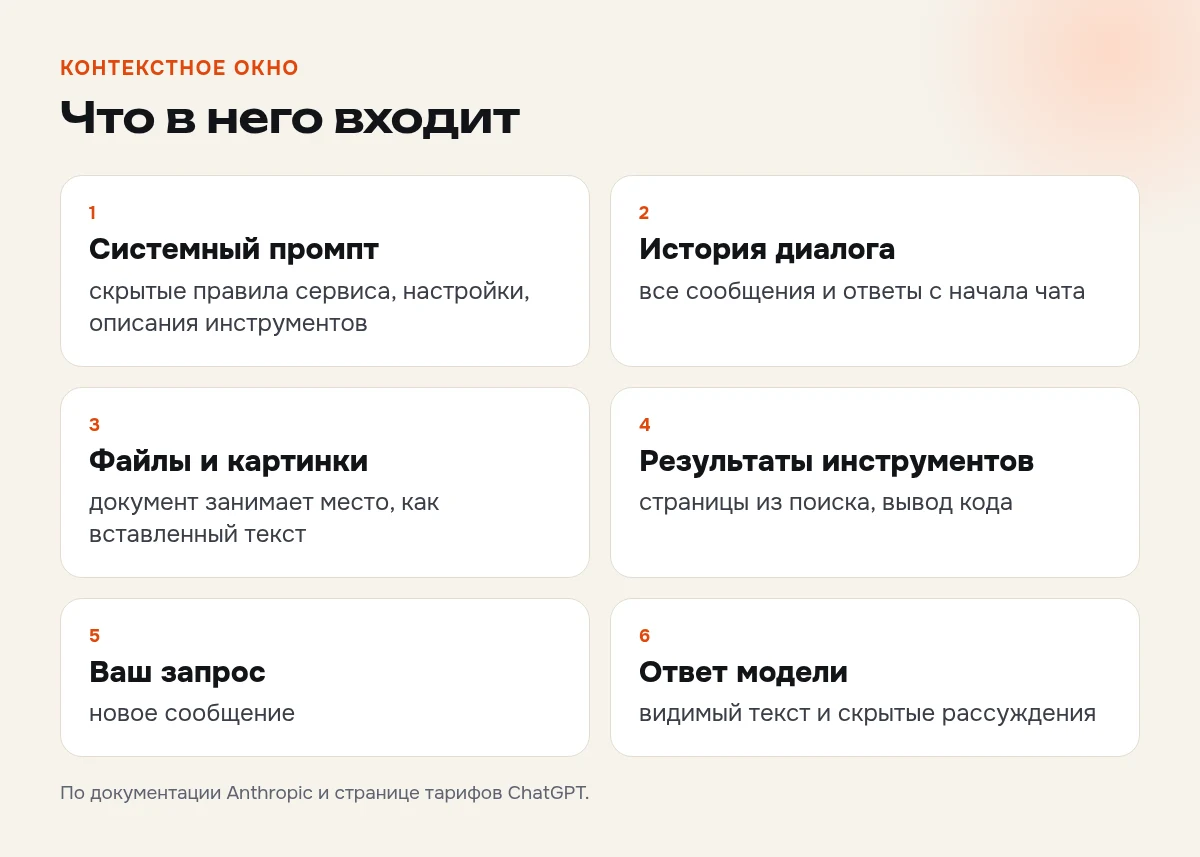
Поэтому место «под вас» всегда меньше заявленного размера. OpenAI прямо пишет об этом на странице тарифов ChatGPT: часть окна занимают системные инструкции, включая инструменты и персональные настройки, память, если она включена, и внутренняя обработка — поиск, рассуждения и формирование ответа. Доступный для ввода объём там указан как приблизительный, он меняется в зависимости от функций и содержимого памяти.
Почему модель забывает начало диалога?
Модель не хранит переписку у себя в голове. Каждый раз, когда вы отправляете сообщение, сервис заново собирает в окно историю диалога и отдаёт её модели целиком. Пока разговор короткий, всё помещается. Длинный чат рано или поздно упирается в предел.
Дальше у сервиса два пути:
- Обрезать старое. Anthropic пишет, что чат-интерфейсы могут управлять окном по принципу «первым пришёл — первым ушёл»: самые ранние сообщения выпадают, чтобы освободить место для новых.
- Сжать старое. В Claude на платных тарифах, если включено выполнение кода, при приближении к пределу модель сама пересказывает ранние сообщения, чтобы разговор шёл дальше. Такие длинные чаты тратят больше лимита.
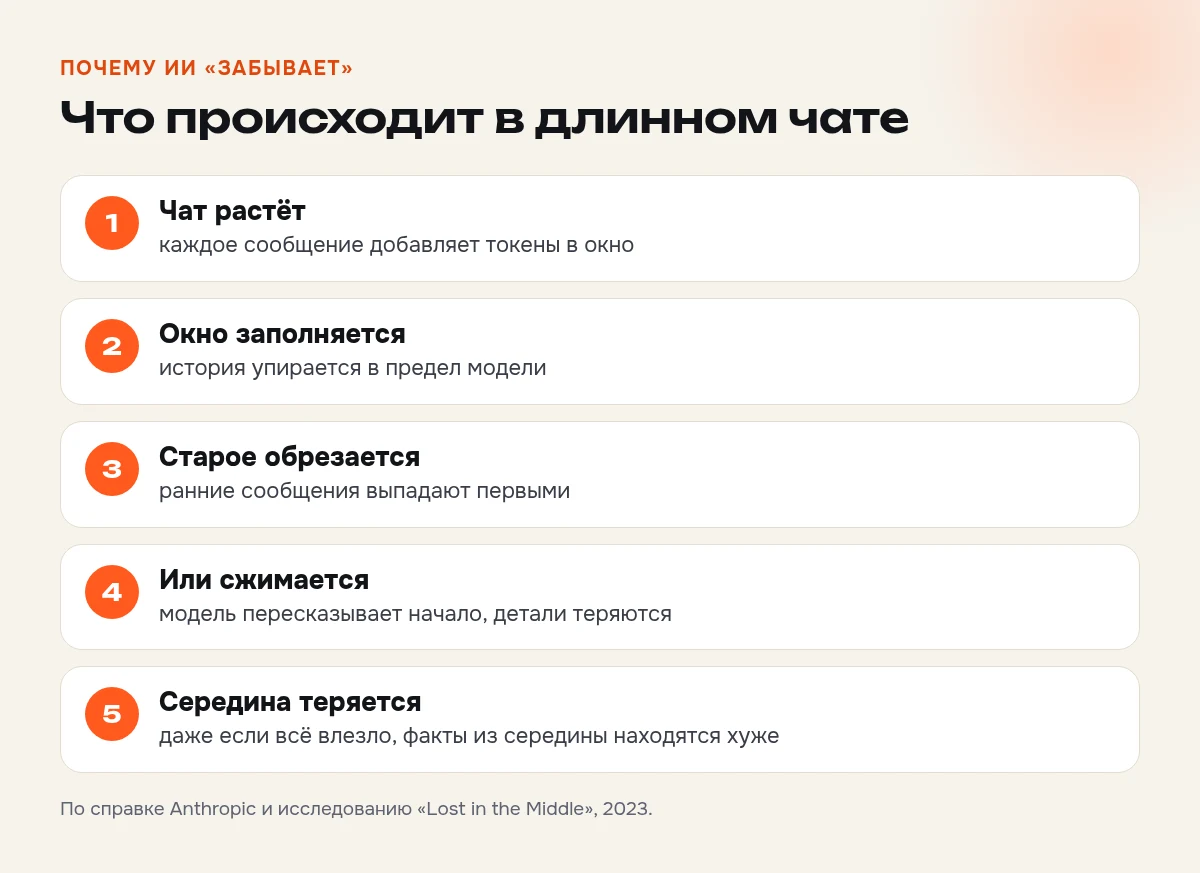
Есть и вторая причина, не связанная с переполнением. В исследовании «Lost in the Middle» (Нельсон Лю и соавторы, 2023) модели лучше всего находили нужный факт, когда он стоял в начале или в конце длинного текста. Если тот же факт оказывался в середине, качество заметно падало, даже у моделей с большим окном. Anthropic называет похожий эффект context rot: чем больше токенов в окне, тем хуже точность и припоминание.
Итог для практики: «забыл» не всегда значит «не влезло». Иногда влезло, но затерялось в середине.
Какой размер контекстного окна у ChatGPT, Claude, Gemini и DeepSeek?
Размер зависит не только от модели, но и от тарифа и от того, где вы ей пользуетесь: в чате, в приложении для кода или через API. Ниже — данные с официальных страниц на 28 октября 2026 года.
| Сервис | Где | Размер окна |
|---|---|---|
| ChatGPT, быстрая модель | чат | Free 27 тыс., Go и Plus 54 тыс., Pro 128 тыс. токенов |
| ChatGPT, модель с рассуждениями | чат | Free — меняется, Go и Plus 256 тыс., Pro 400 тыс. токенов |
| Claude, новые модели (Opus 5.5, Sonnet 5.5, Haiku 5.5 и др.) | чат на платных тарифах | 1 млн токенов |
| Claude, часть моделей (Opus 4.8, Sonnet 4.6 и др.) | чат на платных тарифах | 500 тыс. токенов |
| Claude, остальные модели | чат на платных тарифах | 200 тыс. токенов, около 500 страниц |
| Gemini 4 | API | 1 048 576 токенов на вход, выход и рассуждения вместе |
| DeepSeek | все официальные сервисы | 1 млн токенов по умолчанию |
На странице тарифов ChatGPT есть понятный перевод в страницы. На быструю модель за один раз можно отдать примерно 12 страниц текста на Free, около 40 на Go и Plus и около 250 на Pro. С рассуждениями — около 320 страниц на Go и Plus и около 680 на Pro.
Если статья попала в точку, в канале есть продолжение.Без рассылки на почту, только Telegram
Подписаться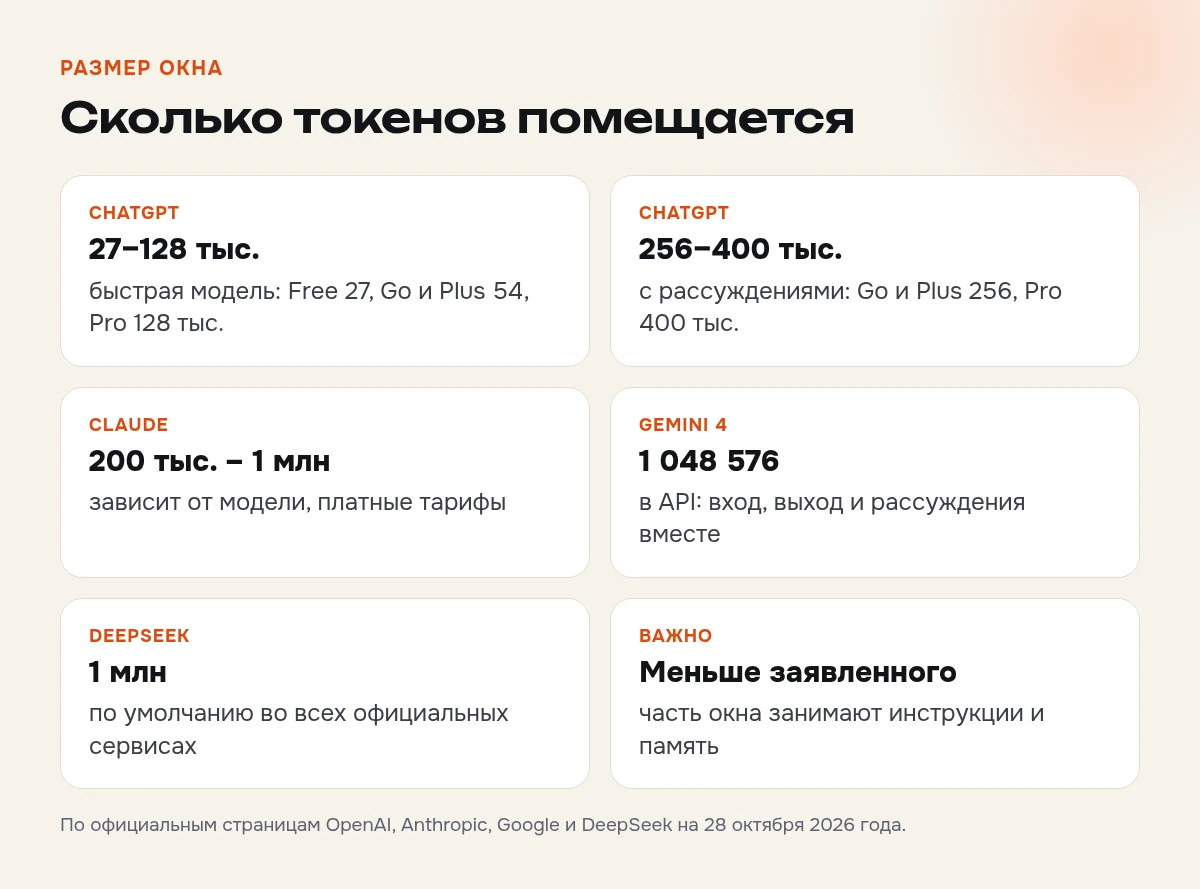
Чтобы представить миллион токенов, Google приводит примеры: это около 50 000 строк кода, 8 романов средней длины на английском или расшифровки более 200 выпусков подкастов. DeepSeek с весны 2026 года сделал миллион токенов стандартом для всех своих сервисов (как ими пользоваться — в статье DeepSeek: как пользоваться), а в API у моделей DeepSeek окно 1M и ответ до 384 тысяч токенов.
Подробнее про то, что ещё ограничивают тарифы, есть в статьях лимиты ChatGPT и лимиты Claude.
Чем контекстное окно отличается от памяти?
Это частая путаница. Контекстное окно работает внутри одного запроса: всё, что модель видит сейчас. Память — отдельная функция сервиса, которая переносит сведения о вас между разными чатами.
В ChatGPT, по справке OpenAI, память может опираться на прошлые чаты, сохранённые воспоминания, пользовательские инструкции, файлы в библиотеке и подключённые приложения. Но она не хранит каждую деталь каждого разговора. ChatGPT сам решает, что из этого относится к текущему ответу, и подтягивает это в окно. А раз подтягивает в окно, память тоже занимает в нём место. Об этом и говорит сноска на странице тарифов.
Проще так: окно — стол, на котором лежат бумаги для текущей задачи. Память — шкаф, из которого сервис иногда достаёт папку и кладёт на стол. Стол от этого не становится больше.
Чем больше окно, тем лучше?
Не всегда. Большое окно позволяет загрузить толстый договор, выгрузку из таблицы или весь код небольшого проекта и задавать вопросы по ним. Раньше для этого приходилось резать документ на куски.
Но у большого окна три минуса:
- Внимание размывается. Anthropic пишет, что больше контекста не значит автоматически лучше: с ростом числа токенов точность падает. Поэтому важно, что именно лежит в окне, а не только сколько места.
- Несколько фактов найти сложнее, чем один. В документации Gemini сказано, что модель хорошо находит одну «иголку в стоге сена», но если нужно найти несколько конкретных фрагментов, точность снижается.
- Дольше и дороже. Google отмечает, что более длинные запросы дольше ждут первого токена ответа. В API платят за каждый токен на входе при каждом запросе, а в чатах длинная переписка быстрее съедает лимит.
Вывод простой: окно — это вместимость, а не качество. Лишнее в окне не помогает, а мешает.
Как работать с контекстом, чтобы нейросеть не теряла важное?
Правила ниже собраны из рекомендаций OpenAI, Anthropic и Google. Они работают в любом чат-боте.
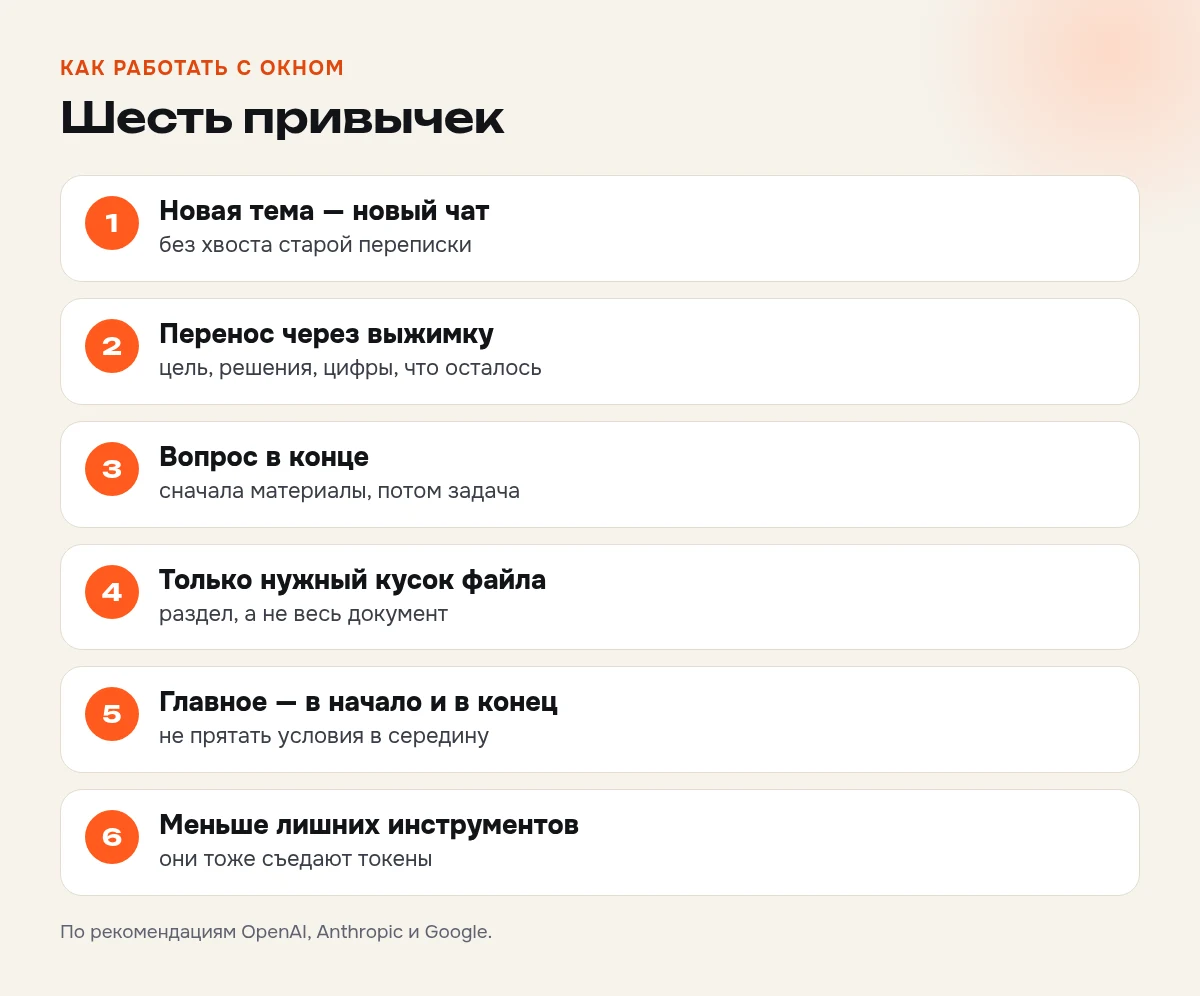
- Новая тема — новый чат. Хвост старой переписки занимает место в окне и сбивает модель: важная информация тонет среди лишней. Если тема сменилась, начните заново.
- Перенос через выжимку. Если чат разросся, попросите модель кратко записать главное: цель, решения, цифры, что осталось сделать. Вставьте эту выжимку первым сообщением в новый чат.
- Вопрос в конце. Google советует при длинном контексте ставить сам вопрос после всех материалов. Сначала документ, потом задача.
- Только нужный кусок файла. Если вопрос про один раздел договора, загружайте раздел, а не все 80 страниц. OpenAI советует при переполнении убирать лишний и повторяющийся контекст и делить большой документ на части.
- Главное — в начало и в конец. Учитывая «Lost in the Middle», ключевые условия лучше повторить в конце запроса, а не прятать в середину длинного текста.
- Меньше лишних инструментов. В справке Claude сказано, что инструменты и подключения расходуют много токенов. Отключайте то, что не нужно в этой задаче.
Я сам работаю так: Grok собирает материал, ChatGPT проверяет логику, выводы возвращаю в Grok. Тот же принцип полезен и для окна: в другой чат лучше переносить не всю переписку, а готовые выводы.
Источники
Все факты проверены 28 октября 2026 года.
- Тарифы ChatGPT, OpenAI — https://chatgpt.com/ru-RU/pricing/
- Memory in ChatGPT, справка OpenAI — https://help.openai.com/en/articles/8590148-memory-faq
- How large is the context window on paid Claude plans, справка Anthropic — https://support.claude.com/en/articles/8606394-how-large-is-the-context-window-on-paid-claude-plans
- Context windows, документация Anthropic — https://platform.claude.com/docs/en/build-with-claude/context-windows
- Большое окно контекста, документация Gemini API (обновлено 15 октября 2026) — https://ai.google.dev/gemini-api/docs/long-context?hl=ru
- Models & Pricing, документация DeepSeek API — https://api-docs.deepseek.com/quick_start/pricing
- DeepSeek V4 Preview Release, DeepSeek, 24 апреля 2026 — https://api-docs.deepseek.com/news/news260424
- Understanding and counting tokens, справка OpenAI — https://help.openai.com/en/articles/4936856-what-are-tokens-and-how-to-count-them
- Liu N. F. и др. Lost in the Middle: How Language Models Use Long Contexts, arXiv, 2023 — https://arxiv.org/abs/2307.03172
Чем точнее задача в первом сообщении, тем меньше уточнений и тем дольше чат помещается в окно. Если хотите сразу писать запросы с целью, ограничениями и критерием «готово», у меня есть пак промптов и ТЗ: шаблоны ТЗ и промпты, которыми я работаю каждый день. Промпты заточены под Grok, шаблоны ТЗ подходят к любой нейросети.
Частые вопросы
Что такое контекстное окно нейросети?
Максимальный объём текста в токенах, который модель учитывает за один раз. В него входят ваш запрос, история чата, файлы, системные инструкции и ответ модели.
Почему ChatGPT забывает, о чём мы говорили в начале?
Длинная переписка перестаёт помещаться в окно, и сервис обрезает или сжимает старые сообщения. Ещё одна причина: даже внутри окна модели хуже замечают то, что лежит в середине длинного текста.
Какое контекстное окно у ChatGPT?
По странице тарифов OpenAI на 28 октября 2026 года у быстрой модели 27 тыс. токенов на Free, 54 тыс. на Go и Plus и 128 тыс. на Pro. У модели с рассуждениями 256 тыс. на Go и Plus и 400 тыс. на Pro.
Какое контекстное окно у Claude, Gemini и DeepSeek?
У новых моделей Claude на платных тарифах 1 млн токенов, у части моделей 500 или 200 тысяч. У Gemini 4 в API 1 048 576 токенов. У DeepSeek 1 млн токенов во всех официальных сервисах.
Контекстное окно и память — одно и то же?
Нет. Окно — то, что модель видит в текущем запросе. Память — функция, которая переносит сведения о вас между чатами. Подтянутые из памяти сведения тоже занимают место в окне.
Пак промптов и ТЗ для Grok
Промпты и шаблоны ТЗ, которыми пользуюсь каждый день.
Дмитрий Гугуян
Делаю сайты с 2016 года, сдал 50+ проектов. Руковожу агентством Рекком. Каждый день работаю с нейросетями и пишу только о том, что проверил сам. Цифры дохода — мой результат, не гарантия.