Содержание статьи
- Что такое токен в нейросети простыми словами?
- Как работает токенизация текста?
- Сколько токенов в слове и почему русский текст дороже?
- Какие токены считает нейросеть: запрос, ответ модели, рассуждения
- Что такое контекстное окно и лимит токенов?
- Почему токены влияют на стоимость запроса?
- Как посчитать токены в своём тексте?
- Как уменьшить расход токенов: советы и ошибки
- Источники
- Частые вопросы
Коротко
- Токен — минимальная единица текста, с которой работает нейросеть. Это может быть целое слово, часть слова, буква, знак препинания или пробел.
- Токен не равен слову. Для английского OpenAI даёт ориентир: 1 токен — около 4 символов, 100 токенов — около 75 слов. Русский текст делится мельче.
- В токенах считают всё: ваш запрос, историю диалога, файлы, ответ модели и её скрытые рассуждения. От этого зависят лимиты и цена.
- Посчитать токены можно бесплатно: токенизатор OpenAI, библиотека tiktoken, счётчики в API Google и Anthropic.
Что такое токен в нейросети простыми словами?
Токен — это кусочек текста, который языковая модель (LLM) обрабатывает как одну единицу. Нейросеть не читает буквы и слова так, как человек. Перед работой она разбивает текст на токены и дальше работает уже с ними.
В справке OpenAI сказано прямо: токен может быть одним символом, частью слова, целым словом или знаком препинания. На разбивку влияют даже пробелы. Google в документации Gemini пишет то же самое: короткое слово может быть одним токеном, длинное делится на несколько. Набор всех токенов, которые знает модель, называют словарём, а сам процесс разбивки — токенизацией.
В канале пишу то, что не доезжает до статьи.Короткие заметки и тесты нейросетей
Читать каналПростая аналогия: токены похожи на слоги, только режет текст не правило русского языка, а словарь конкретной модели. Поэтому у разных моделей один и тот же текст даёт разное количество токенов.
Зачем это знать новичку? Токены — единица учёта во всех нейросетях. В них считают лимиты чата, размер контекста, длину ответа и цену запроса через API. Когда сервис пишет «осталось 50 тысяч токенов» или «до 1 млн токенов контекста», речь именно о них.
Как работает токенизация текста?
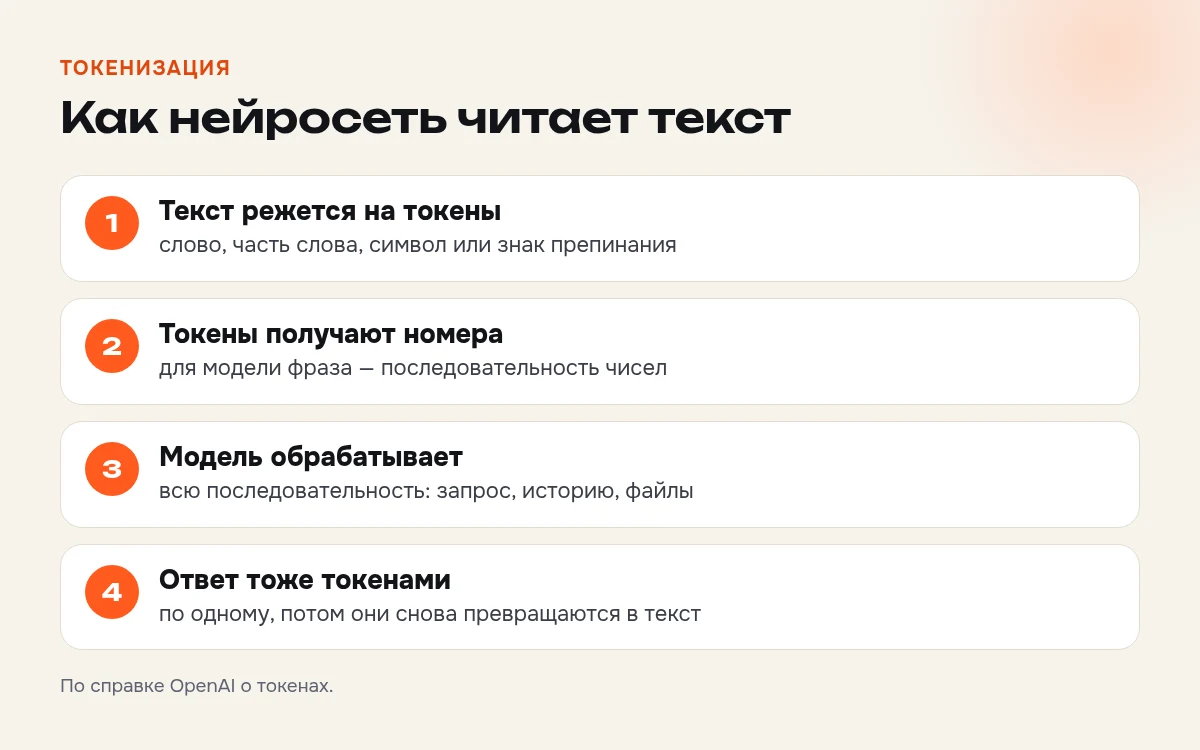
OpenAI описывает процесс в три шага:
- Текст делится на токены. Каждому токену в словаре модели соответствует свой числовой идентификатор, поэтому для модели фраза — это последовательность чисел.
- Модель обрабатывает эти токены.
- Модель генерирует ответ тоже токенами, по одному, и они снова превращаются в текст, который вы видите.
Разбивка зависит от написания. В справке OpenAI пример: «red», «Red» и « red» с пробелом в начале для модели разные фрагменты. Идентификаторы токенов тоже свои у каждой кодировки, поэтому числа из одной модели не подходят к другой.
Токенизация бывает не только у текста. В документации Gemini указано: картинка до 384 пикселей по обеим сторонам — 258 токенов, секунда аудио — 32 токена. Файлы, изображения, инструменты и служебная разметка тоже попадают в счёт.
Сколько токенов в слове и почему русский текст дороже?
Точного правила нет: количество токенов зависит от модели, её кодировки и языка. Есть ориентиры из официальных источников:
- OpenAI, английский текст: 1 токен — примерно 4 символа или три четверти слова, 100 токенов — примерно 75 слов.
- Google, модели Gemini: 1 токен — около 4 символов, 100 токенов — 60–80 английских слов.
- Сбер, GigaChat: в среднем один токен — 3–4 символа.
Для русского языка OpenAI цифр не даёт, только оговорку: в других языках соотношение символов, слов и токенов другое. Разницу легко увидеть, если прогнать фразы через токенизатор OpenAI (библиотека tiktoken, кодировка o200k_base):
| Текст | Слов | Токенов | Как разбилось |
|---|---|---|---|
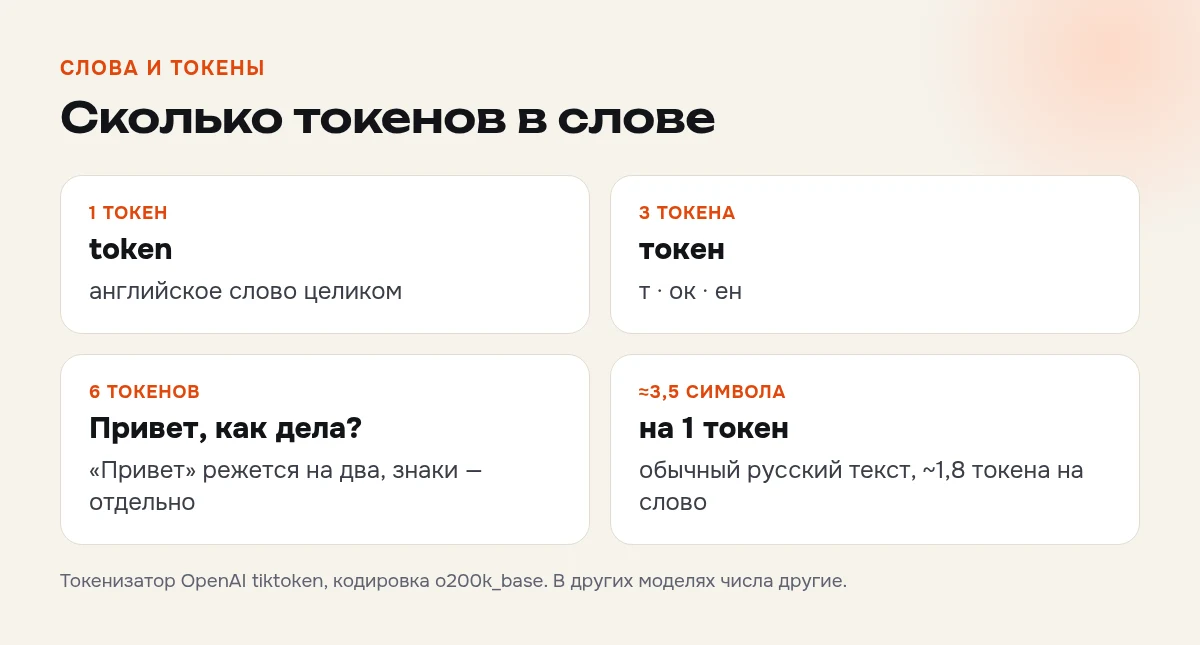
| Hello, how are you? | 4 | 6 | Hello · , · how · are · you · ? |
| Привет, как дела? | 3 | 6 | Пр · ивет · , · как · дела · ? |
| token | 1 | 1 | token |
| токен | 1 | 3 | т · ок · ен |
| интернационализация | 1 | 6 | ин · тер · на · цион · ал · изация |
Если прогнать через tiktoken обычную русскую статью на 11 тысяч знаков, выйдет около 3,1 тысячи токенов: примерно 3,5 символа на токен и 1,8 токена на одно русское слово. Точное число зависит от текста, но порядок сходится с ориентиром Сбера: 3–4 символа на токен.
Вывод простой: в токенах русский текст выходит длиннее английского такого же объёма. Значит, лимиты кончаются быстрее, а запросы через API стоят дороже.
Какие токены считает нейросеть: запрос, ответ модели, рассуждения
В справке OpenAI токены делят на четыре вида:
- Входные токены. Всё, что вы отправили модели: вопрос, системные инструкции, история диалога, файлы.
- Выходные токены. То, что модель сгенерировала в ответ.
- Кэшированные входные токены. Повторяющееся начало запроса, которое сервис запомнил. Цена у них может отличаться от обычных входных.
- Токены рассуждений. Рассуждающие модели думают перед ответом. Эти токены вы не видите, но они считаются как выходные и оплачиваются как выходные.
Отсюда частое удивление: короткий видимый ответ может съесть больше токенов, чем кажется по его длине. Модель сначала долго рассуждала, и всё это попало в счёт.
Ещё одна деталь: в чате каждое новое сообщение отправляет модели и всю предыдущую историю переписки. Чем длиннее диалог, тем больше входных токенов уходит на каждый шаг.
Если статья попала в точку, в канале есть продолжение.Без рассылки на почту, только Telegram
Подписаться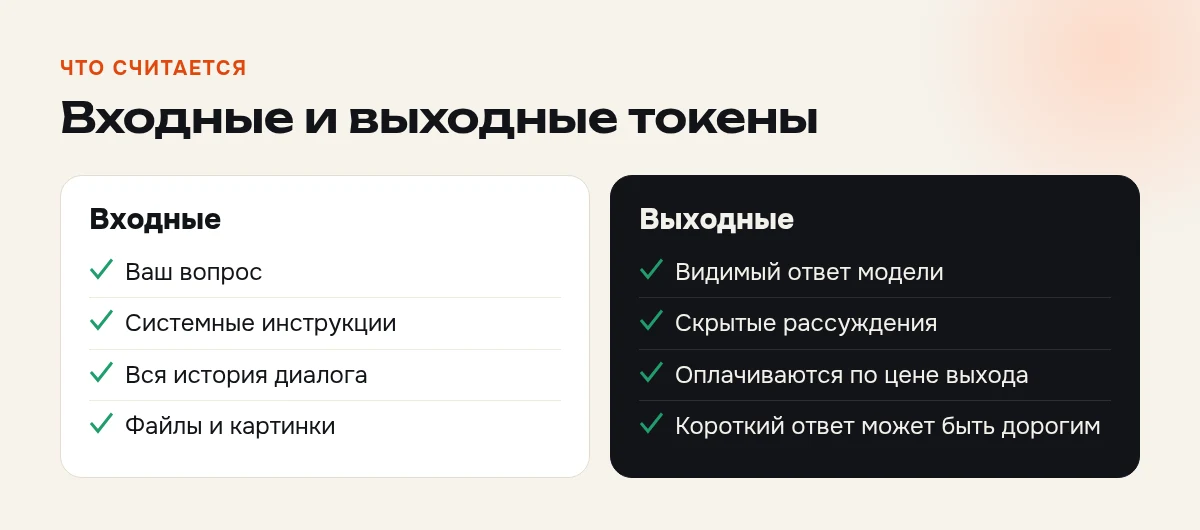
Что такое контекстное окно и лимит токенов?
Контекстное окно — это максимальное число токенов, с которым модель может работать в одном запросе. Туда входят ваш текст, история диалога, файлы и ответ. Отдельно у моделей есть лимит на длину ответа.
Размер окна у каждой модели свой. У моделей Gemini, по документации Google, окно до 1 048 576 токенов, то есть около миллиона. Подробнее про то, сколько контекста дают тарифы ChatGPT и Claude, я писал в статьях про лимиты ChatGPT и лимиты Claude.
Что ещё занимает место в окне, почему нейросеть «забывает» начало разговора и какой размер окна у ChatGPT, Claude, Gemini и DeepSeek, разобрано в статье что такое контекстное окно.
Что делать, если текст не влезает, OpenAI советует так: сократить или переформулировать запрос, убрать лишний и повторяющийся контекст, разбить большой документ на части, сначала сделать краткое изложение.
Почему токены влияют на стоимость запроса?
В обычном чате по подписке вы платите за тариф, а токены тратятся внутри лимитов. В API, когда нейросеть встраивают в свой сервис, платят прямо за токены. Цену обычно указывают за миллион токенов, и входные с выходными стоят по-разному.
Пример с российским сервисом. По тарифам Сбера для физлиц пакет GigaChat Lite — 20 млн токенов за 1 300 ₽ в месяц. Если один токен — 3–4 символа, это примерно 60–80 млн символов текста в обе стороны. Что ещё входит в бесплатный объём, разбирал в статье ГигаЧат бесплатно.
Две ловушки, о которых пишут сами разработчики моделей:
- Цена за миллион токенов не равна цене задачи. OpenAI предупреждает: модель с более низкой ценой не обязательно обойдётся дешевле. Разные модели по-разному режут один и тот же текст, пишут ответы разной длины и по-разному много рассуждают. Сравнивать нужно на своих реальных задачах.
- Новая модель может считать по-новому. Anthropic пишет, что у Claude Opus 4.7 и более новых моделей новый токенизатор: тот же текст даёт примерно на 30% больше токенов, чем на старых моделях. Старые замеры для оценки бюджета переиспользовать нельзя.
Как посчитать токены в своём тексте?
Бесплатные способы, которые дают сами разработчики:
- Токенизатор OpenAI на сайте platform.openai.com/tokenizer. Вставляете текст, видите число токенов и как он разбит.
- Библиотека tiktoken. Если вы пишете код, она считает токены для моделей OpenAI локально. Примеры разбивки выше посчитаны ей.
- Счётчик Gemini. В API Google есть метод count_tokens, он считает входные токены до отправки.
- Счётчик Claude. В API Anthropic есть отдельный эндпоинт подсчёта. По документации он бесплатный, у него только свои ограничения по частоте запросов.
После запроса точный расход показывает сам ответ API: поля с входными, выходными и общими токенами. Для оценки на глаз хватит грубого правила для tiktoken: русское слово — около двух токенов.
Как уменьшить расход токенов: советы и ошибки
Советы по мотивам справок OpenAI и Anthropic плюс то, что работает у меня:
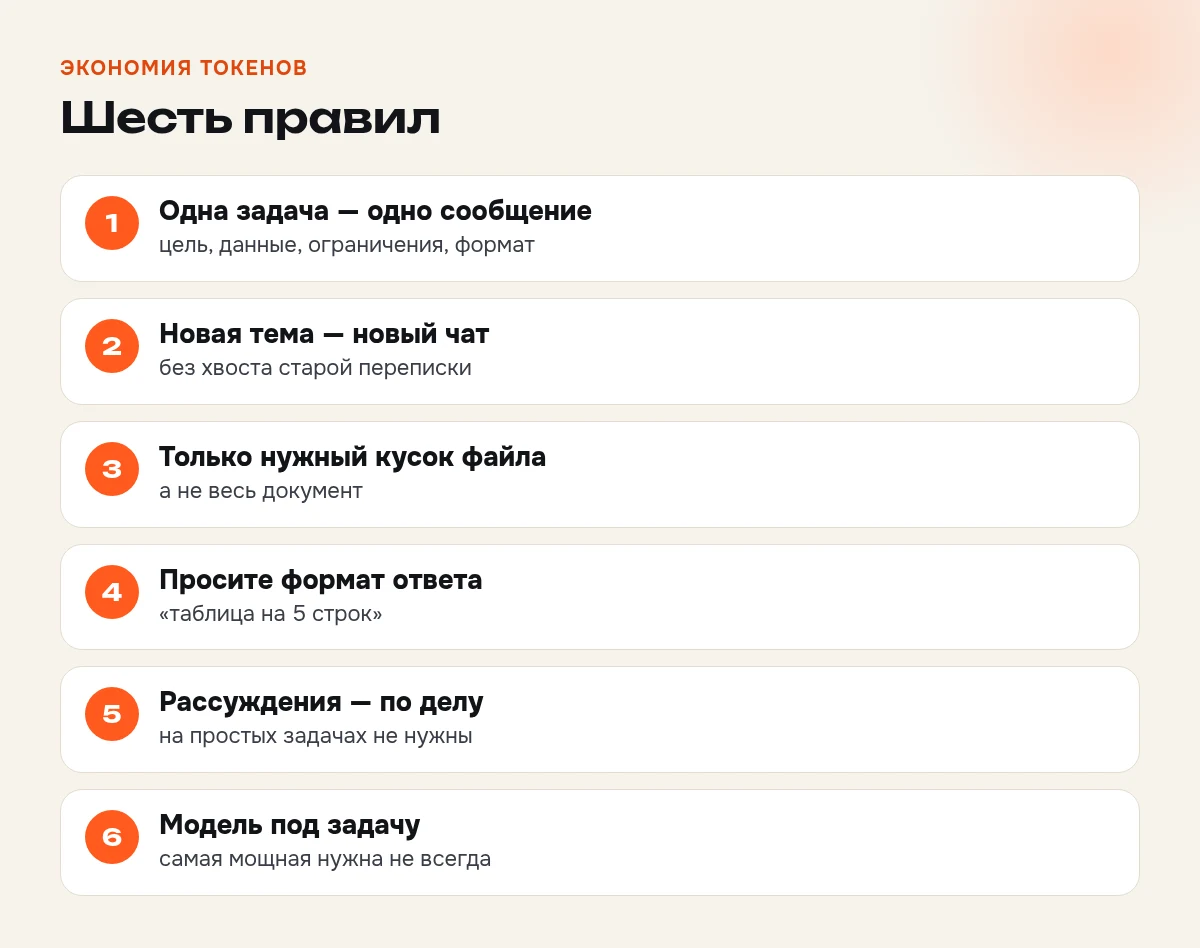
- Одна задача — одно сообщение. Пишите сразу цель, данные, ограничения и формат ответа. Каждое «нет, не так» отправляет модели всю историю заново.
- Новая тема — новый чат. Длинная переписка тянет за собой весь прошлый контекст.
- Убирайте лишнее из файлов. Не нужен весь документ — дайте нужный кусок.
- Просите формат ответа. «Таблица на 5 строк» вместо «расскажи подробно» экономит выходные токены.
- Не включайте рассуждения на простых задачах. Токены рассуждений считаются как выход.
- Выбирайте модель под задачу. Самая мощная нужна не всегда.
Я сам работаю так: Grok собирает материал, ChatGPT проверяет логику, выводы возвращаю в Grok.
Частая ошибка новичков — считать токены словами. В русском тексте слов будет почти вдвое меньше, чем токенов. Если сервис обещает «100 тысяч токенов», это примерно 50–55 тысяч русских слов, а не 100 тысяч.
Источники
Все факты проверены 28 октября 2026 года.
- Understanding and counting tokens, справка OpenAI — https://help.openai.com/en/articles/4936856-what-are-tokens-and-how-to-count-them
- Tokenizer, OpenAI — https://platform.openai.com/tokenizer
- tiktoken, репозиторий OpenAI — https://github.com/openai/tiktoken
- Understand and count tokens, документация Gemini API (обновлено 13 октября 2026) — https://ai.google.dev/gemini-api/docs/tokens
- Token counting, документация Anthropic — https://platform.claude.com/docs/en/build-with-claude/token-counting
- Квоты и ограничения GigaChat API, документация Сбера — https://developers.sber.ru/docs/ru/gigachat/limitations
- Тарифы GigaChat API для физлиц, документация Сбера — https://developers.sber.ru/docs/ru/gigachat/tariffs/individual-tariffs
Токены тратятся быстрее всего на уточнения, когда задача поставлена расплывчато. Чтобы ставить её сразу с целью, ограничениями и критерием «готово», у меня есть пак промптов и ТЗ: шаблоны ТЗ и промпты, которыми я работаю каждый день. Промпты заточены под Grok, шаблоны ТЗ подходят к любой модели.
Частые вопросы
Что такое токен в нейросети простыми словами?
Кусочек текста, который модель обрабатывает как одну единицу: целое слово, часть слова, символ или знак препинания. Нейросеть сначала режет текст на токены, а потом работает с ними.
Сколько токенов в одном слове?
Зависит от языка и модели. Для английского OpenAI даёт ориентир: 100 токенов — около 75 слов. В токенизаторе OpenAI (tiktoken) русское слово в среднем занимает около 1,8 токена.
Почему русский текст тратит больше токенов?
Русские слова чаще режутся на части: в токенизаторе OpenAI «token» — один токен, а «токен» — три. OpenAI в справке тоже предупреждает, что в других языках соотношение символов и токенов иное.
Считаются ли в токенах ответы нейросети?
Да. Считаются и вход, и выход. У рассуждающих моделей ещё и скрытые рассуждения: по справке OpenAI, они оплачиваются как выходные токены.
Где бесплатно посчитать токены?
В токенизаторе OpenAI на сайте platform.openai.com/tokenizer. Разработчики могут использовать библиотеку tiktoken, метод count_tokens в Gemini API или бесплатный эндпоинт подсчёта у Anthropic.
Пак промптов и ТЗ для Grok
Промпты и шаблоны ТЗ, которыми пользуюсь каждый день.
Дмитрий Гугуян
Делаю сайты с 2016 года, сдал 50+ проектов. Руковожу агентством Рекком. Каждый день работаю с нейросетями и пишу только о том, что проверил сам. Цифры дохода — мой результат, не гарантия.